用一条曲线描述执行时间,会把超时概率低估多少倍?
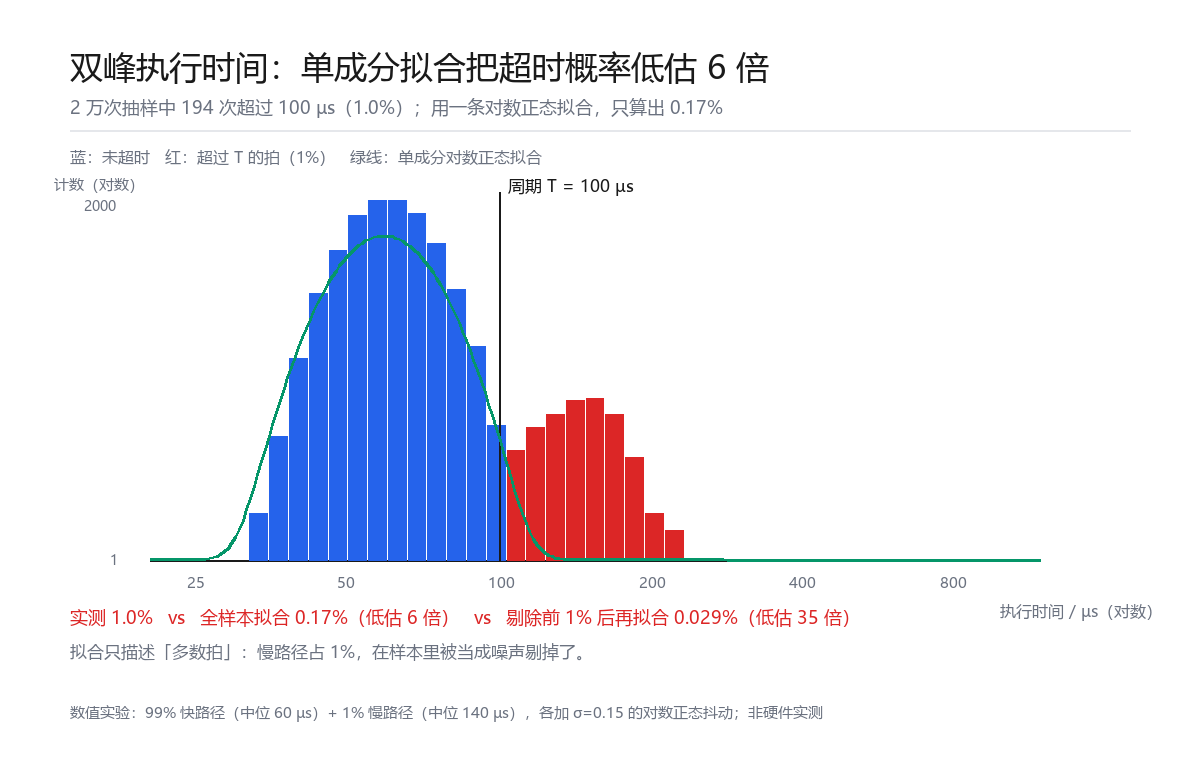
双峰执行时间下,2 万次抽样实测 1.0% 的拍超过周期;用一条对数正态拟合只有 0.17%(低估 6 倍),把最高 1% 当离群点剔掉再拟合只剩 0.029%(低估 35 倍)。
执行时间往往不是一个峰,而是两个:多数拍走快路径,少数拍走慢路径。用一条曲线去拟合整体,会把这个慢路径当成噪声抹平。实测:2 万次抽样中 194 次超过 100 µs(1.0%),单成分拟合给出 0.17%;把最高 1% 当"离群点"剔掉再拟合,只剩 0.029%——低估 35 倍。
现象
工程上描述执行时间,常用三个数之一:平均值、最大值、或者"看起来像对数正态的一条曲线"。三个都不够。
| 描述方式 | 数值(同一批样本) | 问题 |
|---|---|---|
| 平均值 | 约 61 µs | 与尾部无关 |
| 最大值 | 892 µs(N=10 万) | 随样本量增长,不是分布属性 |
| 单条拟合曲线 | 峰值 60 µs、σ 0.17 | 只描述快路径 |
更糟的是"清洗数据"的习惯:看到少数特别大的点,判定为"测量异常"直接删掉。而在双峰分布里,那些点正是尾部本体。
原因
① 双峰来自路径,不来自噪声。 慢路径通常对应可解释的原因:走了某个分支、发生了一次缓存缺失、总线被 DMA 占用、中断嵌套多一层。它们不服从快速路径的分布,所以单成分拟合必然失真。
② 剔除"离群点"等于删掉证据。 本文实验里慢路径占 1%,恰好落在很多人"剔除前 1%"的经验阈值上——于是被删掉的比例正好等于需要观察的比例。剔除后 σ 从 0.1715 降到 0.1490,尾部概率从 0.17% 掉到 0.029%。
③ 最大值随样本量增长。 同一分布下:
| 样本量 | 最大值 | p99 |
|---|---|---|
| 1 000 | 339 µs | 243 µs |
| 10 000 | 585 µs | 239 µs |
| 100 000 | 892 µs | 240 µs |
p99 稳定在 240 µs 附近,最大值却翻了近三倍。"我测到的最大值是 339 µs"这句话,只说明你测了 1000 次。
④ 要看见罕见的拍,需要足够多的样本。 若超时概率是 p,要 95% 概率至少看到一次,样本量约为 3/p。p=1% 时只需约 294 次;但 p=1e-6 时需要约 300 万次——这通常不现实,所以必须靠尾部模型,而不是靠"多跑几遍"。
怎么做
第一步:先看直方图,别急着拟合。 对数横轴上的直方图能直接暴露双峰;线性横轴会把慢路径压成看不见的一小撮。
第二步:按路径分组,而不是按数值分组。 若慢路径对应某个分支,就分别统计两组的分布;这比拟合混合模型更可靠,也更容易解释。
第三步:报告"样本量 + 观测到的次数",不要只报概率。
import math
import numpy as np

T, P_SLOW = 100e-6, 0.01
FAST, SLOW, SIG = 60e-6, 140e-6, 0.15

def p_over(median, sigma, thr=T):
    z = (math.log(thr) - math.log(median)) / (sigma * math.sqrt(2))
    return 0.5 * (1 - math.erf(z))

rng = np.random.default_rng(20261029)
N = 20000
slow = rng.random(N) < P_SLOW
x = np.where(slow, SLOW, FAST) * np.exp(rng.normal(0, SIG, N))
print("实测超时比例 %.4f(%d/%d)" % ((x > T).mean(), (x > T).sum(), N))

lg = np.log(x)
print("全样本拟合  P=%.4g(σ=%.4f)"
      % (p_over(math.exp(lg.mean()), lg.std(ddof=1)), lg.std(ddof=1)))

keep = x <= np.quantile(x, 0.99)
lg2 = np.log(x[keep])
print("剔除前 1%%  P=%.4g(σ=%.4f)"
      % (p_over(math.exp(lg2.mean()), lg2.std(ddof=1)), lg2.std(ddof=1)))
验证
同一次抽样(N=20000,随机种子固定),三种处理方式的结果:
| 处理方式 | 得到的超时概率 | 相对真值 |
|---|---|---|
| 实测计数(194/20000) | 0.97% | 基准 |
| 全样本单成分拟合 | 0.17% | 低估 6 倍 |
| 剔除最高 1% 后再拟合 | 0.029% | 低估 35 倍 |
| 真值(由生成参数解析) | 1.02% | — |
改前剔掉前 1% 再拟合 → 改后保留全部样本并分组统计:超时概率从 0.029% 修正到 1.0%,两句话描述的完全是两个系统。
边界
- 本文的分布是人造的(99% 快路径 + 1% 慢路径),用来演示方法失效的机制,不是任何真实硬件的测量结果。
- 剔除离群点在有些场合是合法的:已确认的仪表毛刺、通信重传导致的重复采样。但前提是有独立证据说明它是测量问题,而不是因为"它太大"。
- 极端值不能外推:从 2 万样本估计 1e-6 的概率,误差会大到没有意义;需要极值理论或按路径建模,并且结论要标成"模型推断"。
- 分位数本身也有不确定性(样本少时尤其大),报告分位数时应同时给样本量。
- 温度、电压、中断负载会改变分布形状,跨工况不能直接套用。
最后验证于 2026-10-29 · 数值实验(Python 3.13 + NumPy,随机种子 20261029,N=20000)· 99% 快路径(中位 60 µs)+ 1% 慢路径(中位 140 µs),σ=0.15 · 模型 v1.0