平均占用率 70% 就算安全吗?
按对数正态模型算:平均占用 70% 时,单拍执行时间超过周期的概率约 3%–9%(1/34–1/11);即使降到 50%,仍有 0.02%–0.7%。安全判据是尾部概率,不是平均占用。
"CPU 占用 70%,还有 30% 余量,应该稳了"——这句话把平均值当成了上界。按对数正态分布估算,平均占用 70% 时,单拍执行时间超过周期的概率约 3%(σL=0.2)到 9%(σL=0.3),也就是每 11–34 拍就有一次超时。要把它压到万分之一以下,平均占用得降到 40% 左右。
现象
这类系统通常表现得很"稳定":跑十分钟没事,跑一小时复位一次;加个日志又正常了。于是排查方向往往跑偏——电源、温度、通信干扰。
真正的问题在于判据选错了:
| 常见判据 | 回答的问题 | 漏掉什么 |
|---|---|---|
| 平均占用率 < 70% | 平均每拍用掉多少时间 | 单拍会不会超过周期 |
| 最坏执行时间 < 周期 | 实测到的最坏值是否越界 | 没测到的那部分有多长 |
| P(执行时间 > 周期) 足够小 | 越界发生的频率 | —— |
前两个都只看"中心",第三个才看"尾部"。
原因
超时的条件是 exec > T,它只跟分布的右尾有关,跟均值没有直接关系。两个系统可以有同样的均值,尾部差一个数量级。
用对数正态描述执行时间是个常用选择(右偏、非负),于是超时概率有闭式解:
P(exec > T) = 1 − Φ( (ln T − μ) / σ ) , μ = ln(平均) − σ²/2
注意 μ 里要减去 σ²/2,这是对数正态的均值与中位数关系;漏掉它,算出的概率会偏小。σ 越大(抖动越大),同样的平均占用下尾部越厚。
怎么做
第一步:先记录分布,不要只记录平均值。 至少要有直方图或分位数;只有均值与最大值两个数,估不出尾部。
第二步:按上面的公式算不同占用率下的超时概率,再反推"能接受多少"。
import math

def p_over(T, util, sigma):
    mu_mean = util * T                      # 平均执行时间
    mu = math.log(mu_mean) - sigma**2 / 2   # 均值 → 对数均值
    z = (math.log(T) - mu) / (sigma * math.sqrt(2))
    return 1 - 0.5 * (1 + math.erf(z))

for util in (0.3, 0.5, 0.7, 0.85):
    for s in (0.2, 0.3):
        p = p_over(100e-6, util, s)
        print("占用 %.0f%%  σ=%.1f  → %.3g (约 1/%.0f)" % (util * 100, s, p, 1 / p))
第三步:给"没测到"的部分一个上限。 跑了 N 次没超时,只能说明概率低于某个上界(95% 置信,Clopper-Pearson 单侧):
上界 = 1 − 0.05^(1/N) ≈ 3 / N
这条比"我跑了十万次都没事"有用得多——它把"没看到"翻译成一个可比较的数字。
验证
T=100 µs,两种对数标准差(尾部厚度)下的超时概率:
| 平均占用 | σL = 0.2 | σL = 0.3 |
|---|---|---|
| 30% | 4.7e-10(1/21 亿) | 1.6e-5(1/6.4 万) |
| 50% | 1.8e-4(1/5512) | 6.9e-3(1/144) |
| 70% | 3.0e-2(1/34) | 9.0e-2(1/11) |
| 85% | 1.8e-1(1/6) | 2.5e-1(1/4) |
"没测到"能保证多少:
| 无超时次数 N | 95% 上界 | 约合 |
|---|---|---|
| 100 | 2.95e-2 | 1/34 |
| 1 000 | 2.99e-3 | 1/334 |
| 10 000 | 3.0e-4 | 1/3339 |
| 100 000 | 3.0e-5 | 1/33382 |
注意一个巧合式的对照:跑 100 次没出错,只能保证超时概率不高于 3%(1/34)——这恰好就是"平均占用 70%、σ=0.2"时的估算值。"我测了 100 次都好的"这句话,几乎没有说服力。
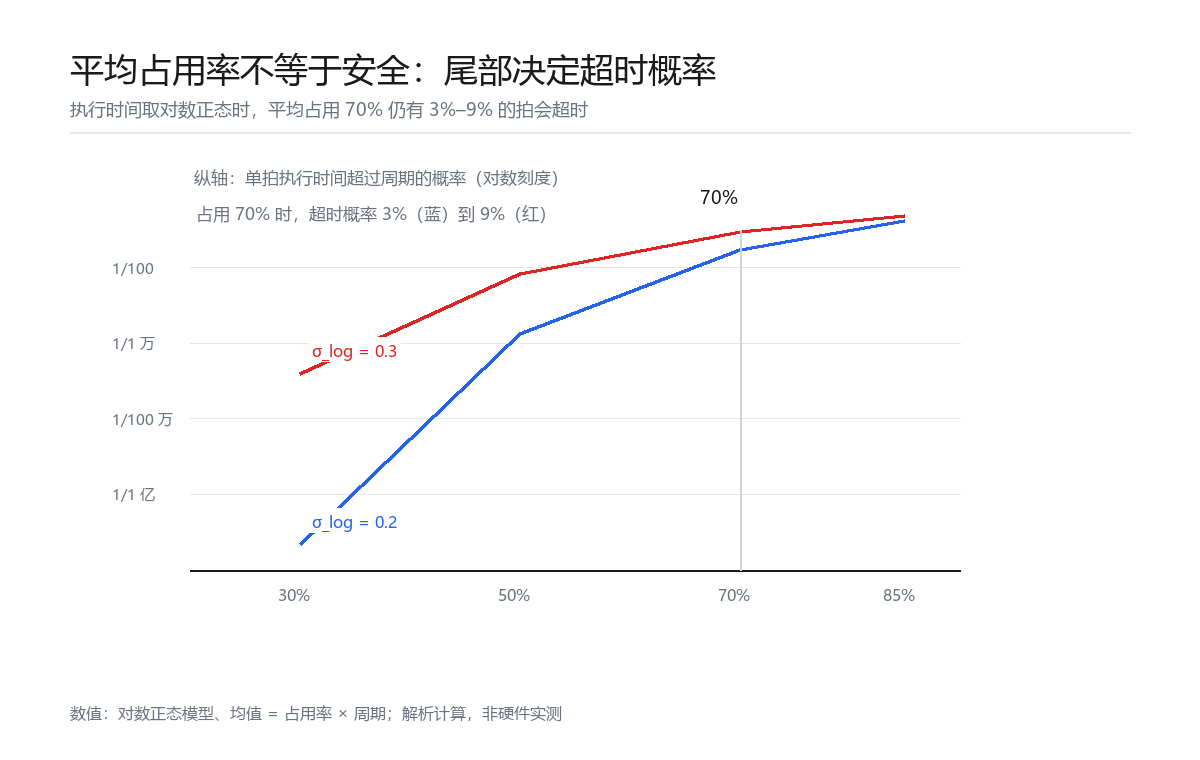
改前按平均占用 70% 判安全 → 改后按尾部概率 1/11–1/34 判风险:同一套系统,判据从"看起来有余量"变成"每十几拍会越界一次"。
边界
- 对数正态只是模型选择。真实执行时间可能是多峰(不同分支)或有硬上界,这时公式会给出偏悲观或偏乐观的估计,必须用实测直方图校验。
- 本文是解析计算,不是硬件实测;T 与占用率都是示例值,替换成你自己的数即可。
- 温度、供电电压、Flash 等待周期、总线争用都会改变分布形状;跨工况外推不可靠,尤其不能把室温下的分布用到高温满载。
- "3/N" 只对无失败的样本成立(0 次成功判据),且假设各次独立同分布;有失败样本时要改用二项分布的区间估计。
- 超时的后果取决于系统设计:丢一拍、输出保持、看门狗复位,严重程度差很多。概率小不等于可以忽略——看门狗会把一次超时放大成一次重启。
最后验证于 2026-10-29 · 解析计算(Python 3.13,math.erf)· 对数正态模型 · T=100 µs · 模型 v1.0