一次采样到一次输出,延迟到底花在哪一段?
周期 100 µs 时,异步采样的平均延迟是 57.02 µs,其中 50 µs 花在「等下一次采样」;换成同步锁相后只剩 7.02 µs。五段分解里,最容易被忽略的那段往往占八成以上。
延迟不是一个数,是五段之和:等待采样的相位 + 转换 + 计算 + 输出锁存 + 执行器响应。以 100 µs 周期、1.5 µs 转换、5 µs 计算为例,固定段合计只有 7.02 µs,但异步采样时平均还要再等 50 µs——等待项占 87.7%,而它通常不出现在任何"延迟"数字里。
现象
很多方案在介绍延迟时,报的是链路上最短的那一段:"输出锁存只要 20 ns"、"计算只要 5 µs"。这些数字本身没错,但它们回答的是"我这一段有多快",不是"从采样到输出要多久"。
两者能差一个数量级。同一个系统,按不同口径可以报出:
| 口径 | 数值 | 说的是什么 |
|---|---|---|
| 只算锁存 | 0.02 µs | DMA 搬运一次 |
| 算到计算结束 | 6.52 µs | 转换 + 计算 |
| 算上采样等待 | 57.02 µs | 从"该采样"到"输出生效"的平均值 |
控制工程师关心的是第三种。
原因
五段里只有四段是"执行时间",第一段是"相位等待",性质完全不同:
总延迟 = φ + t_转换 + t_计算 + t_锁存 + t_执行器 , φ ~ U(0, T)
如果采样是自由运行、与输出不同步,那么"物理量发生变化的那一刻"落在采样栅格之间的位置是随机的,平均要等 T/2。这一项跟 CPU 多快、代码多短毫无关系——它只取决于周期与相位关系。
E[φ] = T/2            (均匀分布)
P90(φ) = 0.9T
max(φ) = T
所以把周期缩小一半,等待项也减半;但把代码优化一半,等待项一点不变。这就是为什么"优化计算"对端到端延迟的收益常常令人失望。
怎么做
第一步:把五段分开列,每段单独给数。 不要只写总延迟。
| 段 | 典型来源 | 怎么测 |
|---|---|---|
| 采样相位等待 | 采样与 PWM/输出是否同源 | 同时看触发信号与采样信号的时间差 |
| 转换 | ADC 采样保持 + 转换时间 | 看转换完成中断/标志,或读数据手册的转换周期 |
| 计算 | ISR 执行时间 | 在 ISR 入口/出口各翻一个 GPIO,示波器量 |
| 输出锁存 | 影子寄存器 → 引脚 | 同上,看最后一跳 |
| 执行器响应 | 驱动芯片、机械时间常数 | 只能实测,手册通常只给上限 |
第二步:判断等待项是否可消。 如果采样由同一个定时器触发(与输出同源),φ 就变成常数而不是随机量:
import random

T = 100e-6
adc, comp, latch, act = 1.5e-6, 5.0e-6, 0.02e-6, 0.5e-6
fixed = adc + comp + latch + act

random.seed(7)
samples = sorted(random.uniform(0, T) + fixed for _ in range(200000))

print("固定段       %.2f us" % (fixed * 1e6))
print("异步均值     %.2f us" % (sum(samples) / len(samples) * 1e6))
print("异步 P90     %.2f us" % (samples[int(0.9 * len(samples))] * 1e6))
print("异步最坏     %.2f us" % (samples[-1] * 1e6))
print("同步(锁相) %.2f us" % (fixed * 1e6))
第三步:把"可消"的那部分消掉。 让采样与 PWM 载波同步(在固定相位点采样),等待项从 T/2 直接变成 0——这是"同步采样"在时序预算上的真正价值,比"提高采样率"划算得多。
验证
用上面的参数做 20 万次抽样(相位均匀分布),与解析值对照:
| 量 | 解析值 | 仿真值 |
|---|---|---|
| 固定段合计 | 7.02 µs | 7.02 µs |
| 异步平均延迟 | 50 + 7.02 = 57.02 µs | 56.98 µs |
| 异步 P90 | 90 + 7.02 = 97.02 µs | 97.03 µs |
| 异步最坏 | 100 + 7.02 = 107.02 µs | 107.02 µs |
| 同步(锁相) | 7.02 µs | — |
结论落在两个数上:等待项占异步均值的 87.7%,同步与异步的均值相差 8.12 倍。
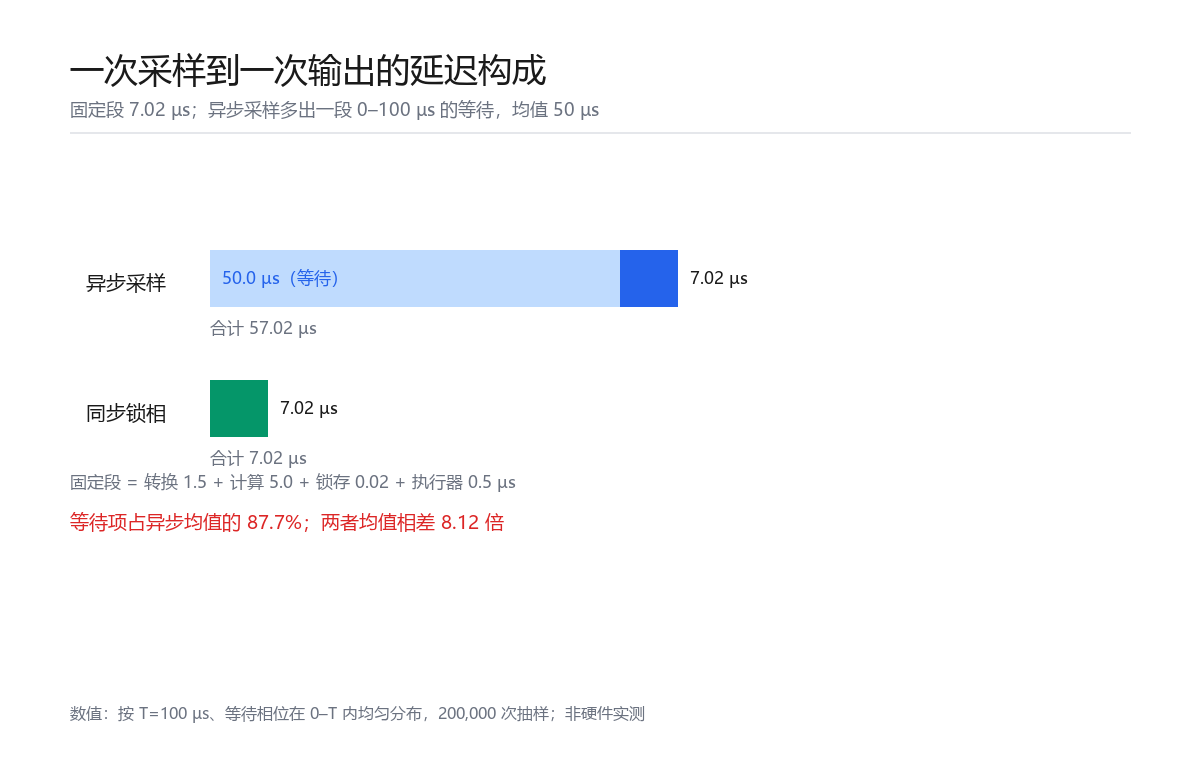
改前只算固定段 7.02 µs → 改后算上等待 57.02 µs,同一套硬件、同一个程序,端到端延迟差了 8 倍——差别不在代码里,在采样与输出的相位关系里。
边界
- 等待项按均匀分布算,前提是采样自由运行且与输出不同源。若两者同源锁相,φ 是常数,应按实际相位差取值,而不是取 T/2。
- 本文数值是数值实验(参数为示例值),不是硬件实测;换一台设备,转换时间与执行器延迟会变,但"等待项占大头"的结构通常不变。
- 执行器响应常被漏掉,而它可能是最大的一项(电磁阀 5–20 ms、机械传动更长)。只测到引脚为止的延迟,不代表闭环延迟。
- 周期远小于对象时间常数时,等待项会被对象滤波"平均掉"一部分,但它仍是纯延迟,会吃掉相位裕度,不能当作不存在。
- 若采样前有模拟前端滤波,那段时间也要计入;它常被算在"传感器精度"里,而在时序上属于延迟。
最后验证于 2026-10-29 · 数值实验(Python 3.13,20 万次抽样)· 示例参数:T=100 µs、转换 1.5 µs、计算 5 µs、锁存 0.02 µs、执行器 0.5 µs